KI im Unternehmen
Ein Index für alles: Kasimir verbindet das Wissen aus all deinen Quellen
Firmenwissen liegt verstreut — in Cloud-Ordnern, Dokumentablagen und Notizen. Kasimir führt es jetzt in einem durchsuchbaren Index zusammen und beantwortet Fragen mit Beleg und Seitenzahl. Was hinter dem größten Wissens-Update seit dem Start steckt.
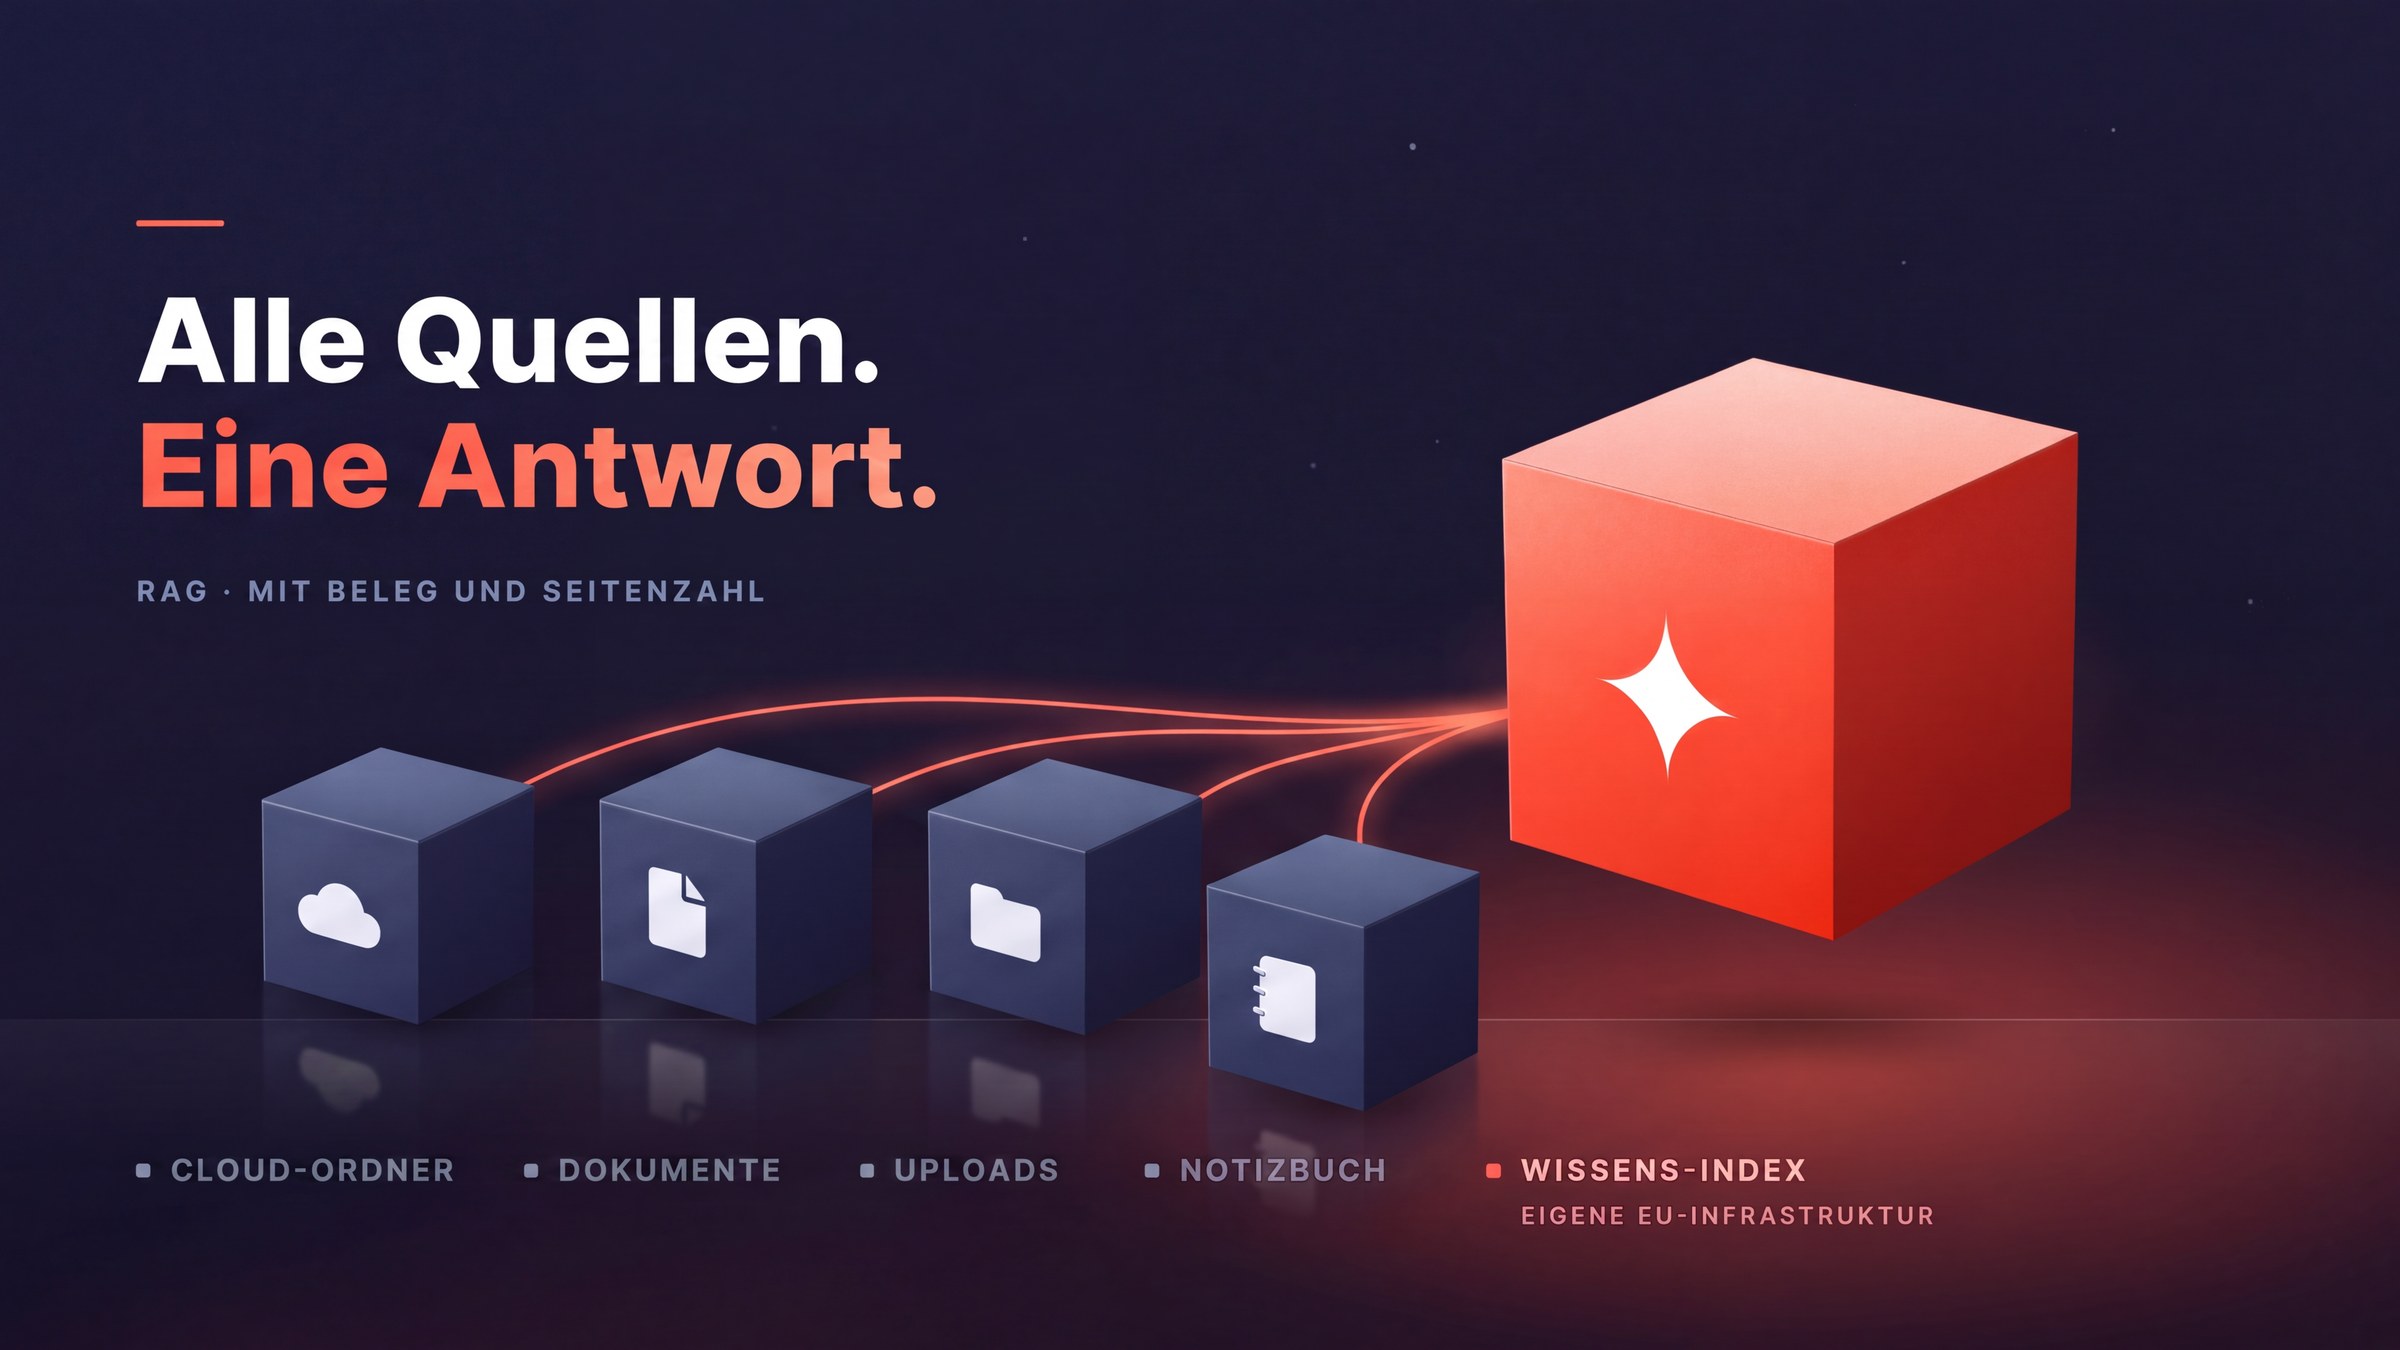
Die Antwort steht in einem Dokument. Die Frage ist nur: in welchem? Firmenwissen liegt selten an einem Ort — es verteilt sich über Cloud-Speicher, Team-Ablagen, lokale Uploads, Besprechungsnotizen und die Köpfe der Kolleginnen und Kollegen. Wer etwas braucht, sucht. Und sucht.
Genau hier setzt unser größtes Update seit dem Start an: Kasimir führt das Wissen aus all deinen Quellen jetzt in einem gemeinsamen, durchsuchbaren Index zusammen — und beantwortet Fragen mit Beleg und Seitenzahl statt mit Vermutungen.
Ein Index für alle Quellen
Verbundene Cloud-Ordner werden Teil des Kasimir-Wissens — unabhängig davon, wo sie liegen (etwa in Nextcloud, ownCloud, OneDrive, SharePoint oder Google Drive). Dasselbe gilt für hochgeladene Dokumente und die Seiten deines Notizbuchs. Im Hintergrund zerlegt Kasimir jedes Dokument in Sinnabschnitte, reichert sie mit Kontext an und macht sie semantisch durchsuchbar. Das Verfahren dahinter heißt Retrieval-Augmented Generation (RAG) — die KI antwortet nicht aus dem Gedächtnis, sondern schlägt in deinen Unterlagen nach.

Das Ergebnis spürst du in jeder Antwort: Kasimir nennt die Quelle, zitiert die Fundstelle und gibt bei PDFs die Seitenzahl an — ein Klick, und du prüfst die Aussage im Original. Gerade bei sicherheitskritischen Themen wie Baunormen oder Vertragsdetails ist dieser Beleg der Unterschied zwischen einem netten Chatbot und einem Werkzeug, dem man vertraut.
Live oder indexiert — du entscheidest pro Ordner
Nicht jedes Wissen altert gleich schnell. Deshalb gibt es beim Verbinden eines Ordners zwei Modi: Indexiert baut einen dauerhaft durchsuchbaren Bestand auf, der automatisch synchron gehalten wird — ideal für Richtlinien, Normen und Projektarchive. Live liest den Ordner bei jeder Frage sekundenaktuell — ideal für den aktiven Projektordner, in dem stündlich neue Dateien landen.
Faustregel: Bestände indexieren, Arbeitsordner live verbinden. Beide Modi lassen sich pro Ordner frei wählen und jederzeit ändern.
Auch Scans und Pläne lesen jetzt mit
Ein erheblicher Teil des Firmenwissens existiert nur als Scan: unterschriebene Verträge, alte Baugenehmigungen, abfotografierte Pläne. Kasimir erkennt solche Dokumente automatisch und liest sie per Vision-OCR — auch schief eingescannte oder gedrehte Seiten. Danach sind sie durchsuchbar wie jedes andere Dokument, inklusive Seitenangabe im Zitat.
Volle Transparenz — für Nutzer und Admins
Wissen, das unsichtbar einfließt, schafft kein Vertrauen. Deshalb zeigt der Chat schon vor der ersten Frage, welche Wissensquellen in die Antwort einfließen würden. Jede verbundene Quelle lässt sich in einem Explorer öffnen: Ordner durchblättern, Dateien samt Index-Status einsehen, direkt im Quelleninhalt suchen. Und Administratoren sehen im zentralen Register alle Quellen des Unternehmens — wer sie verbunden hat, wie weit die Indexierung ist, wo es hakt.
Zugriffsrechte bleiben dabei unangetastet: Was als privat oder projektbezogen freigegeben ist, sehen auch nur die Berechtigten. Der Index erzwingt dieselben Grenzen wie die Quelle.
Und alles bleibt in Europa
Der komplette Wissens-Index läuft auf Kasimirs eigener Infrastruktur in Deutschland — vom Embedding-Modell über die Vektordatenbank bis zur OCR. Deine Dokumente verlassen für keine dieser Funktionen die EU. Das ist kein Feature, sondern unser Fundament: Datensouveränität ist der Grund, warum es Kasimir gibt.
Die Neuerungen im Überblick
Einheitlicher Wissens-Index über Cloud-Ordner, Dokumente und Notizbuch — mit Kontext-Anreicherung für treffsichere Ergebnisse
Zwei Modi pro Ordner: dauerhaft indexiert oder sekundenaktuell live
Zitate mit Seitenzahl — jede Aussage im Original nachschlagbar
Vision-OCR für gescannte PDFs, Fotos und Pläne — EU-gehostet
Quellen-Explorer: jede Quelle durchblättern und im Inhalt suchen
Live-Fortschritt & Admin-Register: volle Sicht auf alle Wissensquellen des Unternehmens
Alle Funktionen sind ab sofort für alle Kasimir-Kunden verfügbar — ohne Aufpreis, ohne Migration. Verbinde einen Ordner und stell die erste Frage.
DSGVO-konforme KI aus einem echten deutschen Rechenzentrum
Kasimir läuft auf eigener Infrastruktur in Deutschland — kein Umweg über US-Anbieter, keine CLOUD-Act-Reichweite.