Grundlagen & Ratgeber
Was ist ein Reranker? Die zweite Meinung in der KI-Suche
Eine Suche findet Kandidaten, ein Reranker wählt aus. Was die zweite Stufe in RAG-Systemen wirklich bringt, was sie nicht bringt, und wie Kasimir sie auf eigener Infrastruktur in Deutschland betreibt.
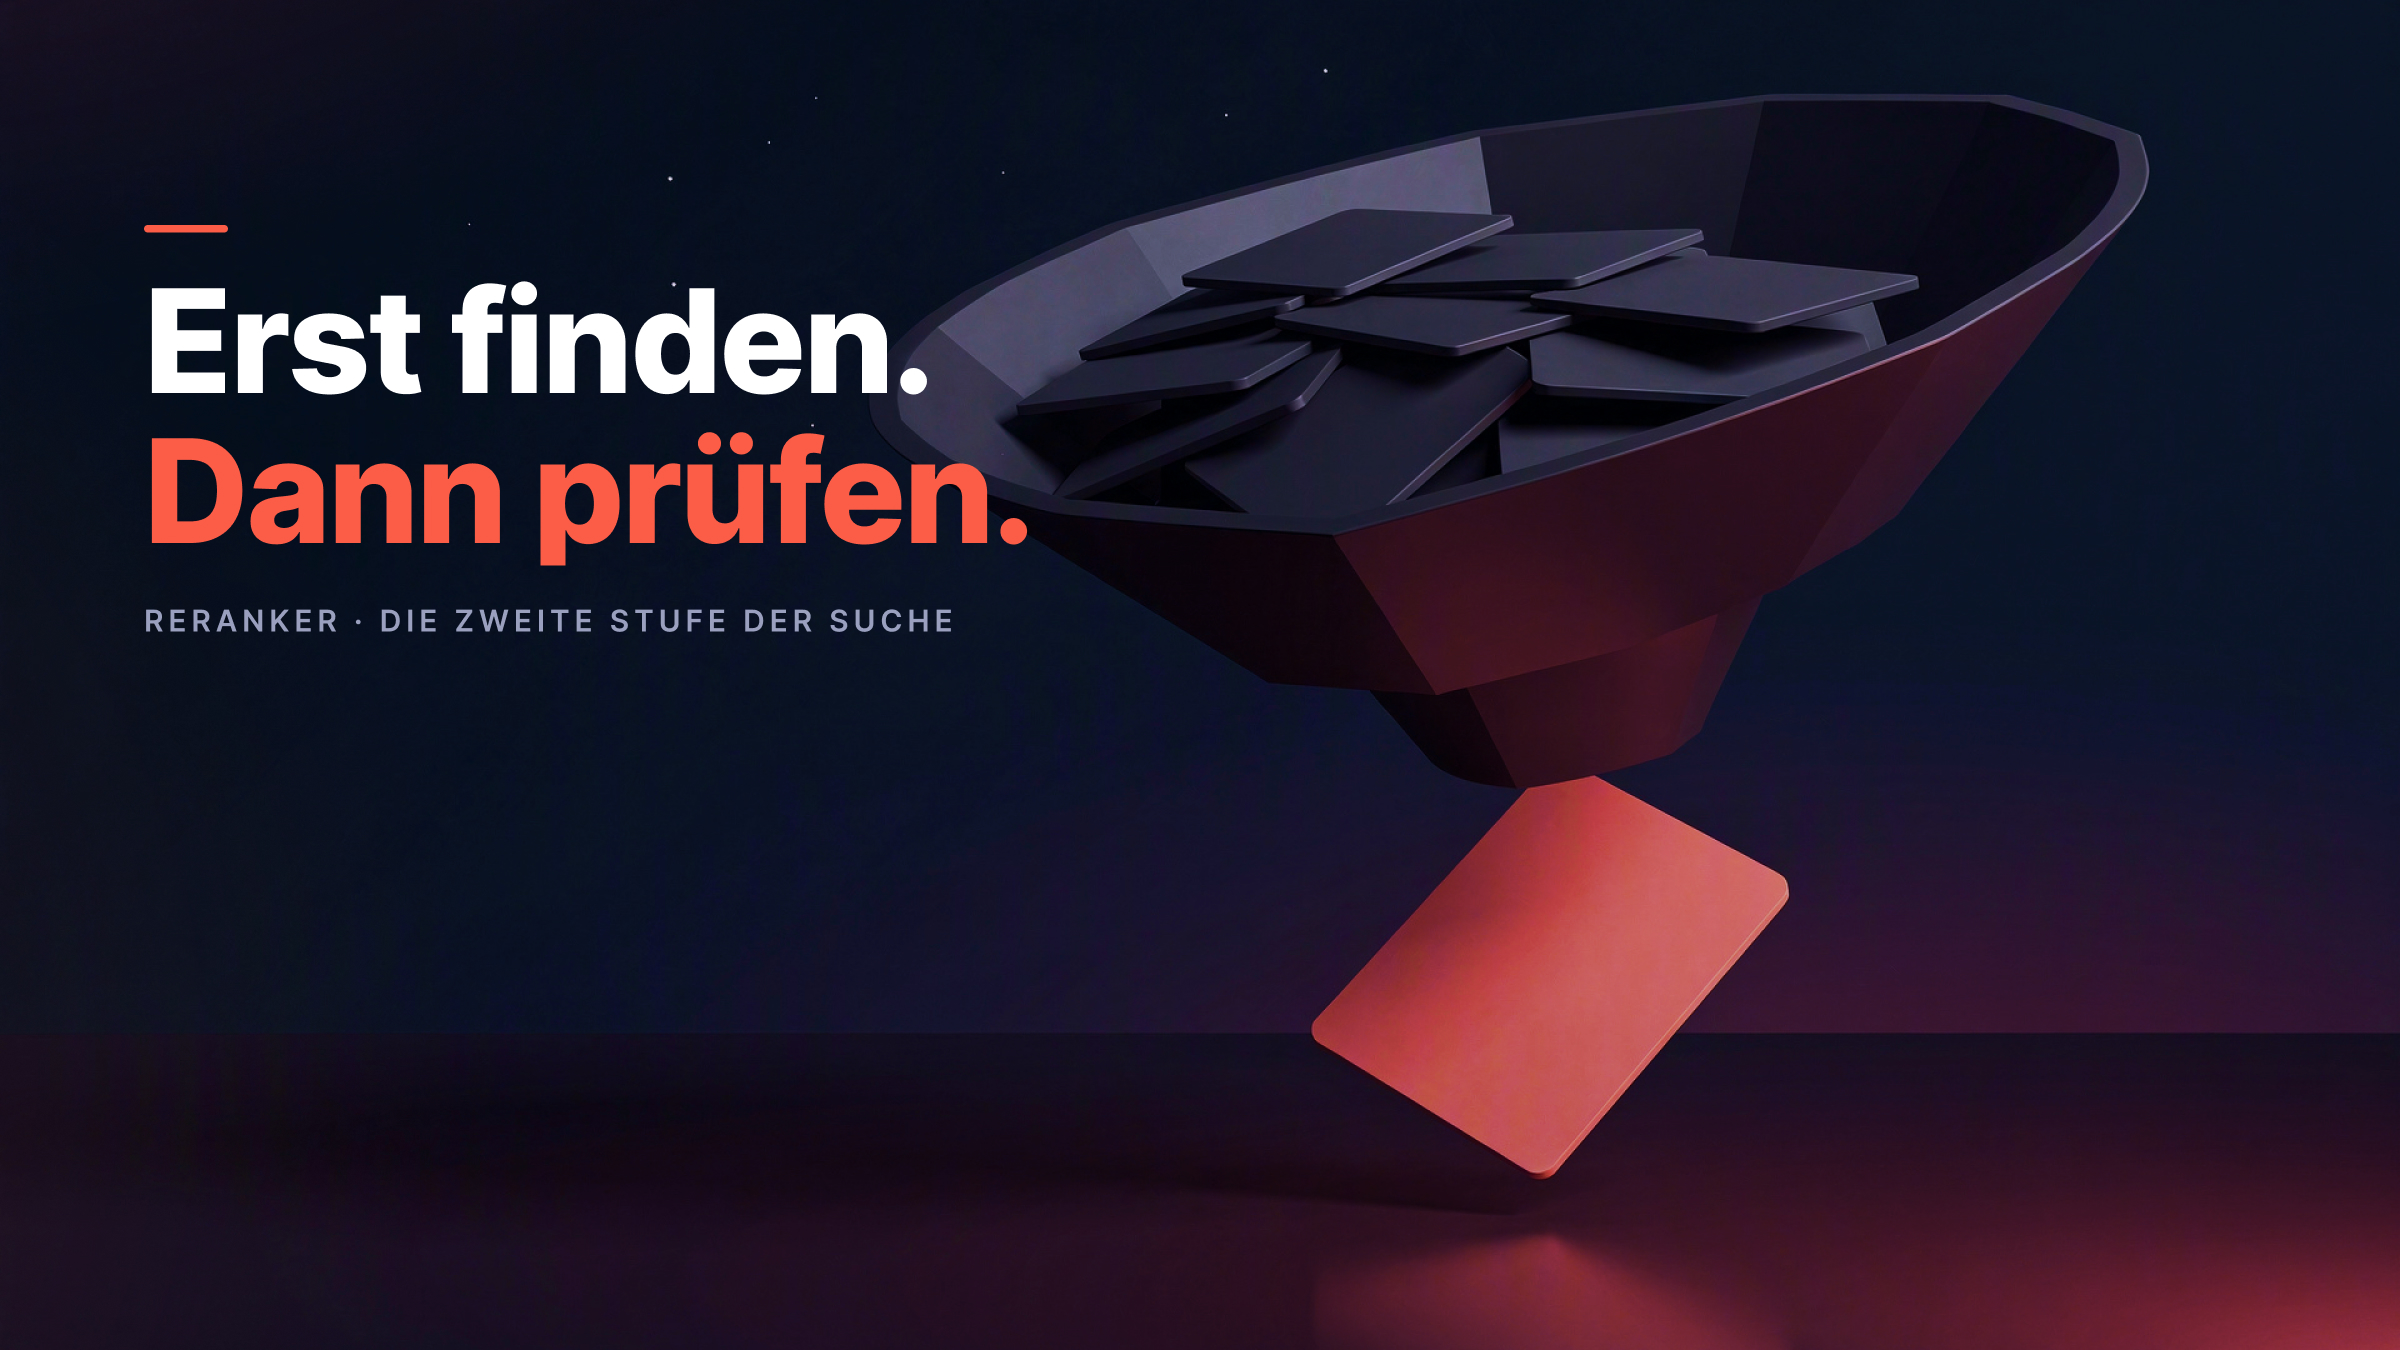
Eine Suche liefert Treffer. Aber die Reihenfolge der Treffer entscheidet, ob eine KI die richtige Antwort gibt oder eine überzeugend klingende falsche. Genau an dieser Stelle arbeitet ein Reranker: Er nimmt die Kandidaten, die eine erste Suche gefunden hat, und sortiert sie noch einmal, diesmal mit dem vollen Verständnis dafür, was die Frage wirklich meint.
Dieser Beitrag erklärt, was ein Reranker ist, was er in der Praxis wirklich bringt, und wie Kasimir ihn einsetzt, auf eigener Infrastruktur in Deutschland.
Zwei Stufen statt einer: Retriever und Reranker
Moderne KI-Systeme, die auf Firmenwissen zugreifen, arbeiten nach dem Prinzip Retrieval-Augmented Generation, kurz RAG. Zu jeder Frage wird zuerst nach passenden Textabschnitten gesucht, dann formuliert das Sprachmodell aus diesen Abschnitten eine Antwort. Die Qualität der Antwort hängt direkt davon ab, was in diesem ersten Schritt gefunden wird.
Die erste Suche, der Retriever, muss schnell sein. Sie vergleicht die Frage mit Tausenden oder Millionen Abschnitten und darf dafür nur Millisekunden brauchen. Das geht nur mit einem Trick: Jeder Abschnitt wird vorab in einen Zahlenvektor übersetzt, eine Art Koordinate seiner Bedeutung. Die Frage bekommt dieselbe Behandlung, und die Suche sucht die nächstgelegenen Koordinaten. Das ist schnell, aber grob. Frage und Abschnitt werden getrennt voneinander betrachtet, sie sehen sich nie gemeinsam.
Der Reranker macht das Gegenteil. Er bekommt nur eine Handvoll Kandidaten, etwa die besten vierzig, und liest jeden davon zusammen mit der Frage. Frage und Text liegen gleichzeitig vor, das Modell kann Bezüge zwischen beiden herstellen: Passt dieser Abschnitt zu dieser Frage? Beantwortet er sie, oder erwähnt er nur zufällig dieselben Wörter? Das Ergebnis ist ein Relevanzwert pro Kandidat, und die Liste wird danach neu sortiert.
In der Fachsprache heißen die beiden Ansätze Bi-Encoder und Cross-Encoder. Der Bi-Encoder kodiert getrennt und ist skalierbar. Der Cross-Encoder kodiert gemeinsam und ist genau. Weil Genauigkeit teuer ist, wird sie nur auf die Kandidaten angewandt, die es in die engere Auswahl geschafft haben.
Warum das in der Praxis so viel ausmacht
Ein erfundenes, aber typisches Beispiel. Jemand fragt: „Bis zu welchem Betrag darf eine Teamleitung eine Rechnung selbst freigeben?“ Die erste Suche findet vierzig Abschnitte aus einem internen Richtlinienhandbuch. Viele davon enthalten die Wörter Rechnung, Betrag oder Freigabe. Der eine Abschnitt, der die Frage tatsächlich beantwortet, landet auf Platz zwölf, hinter elf Abschnitten mit allgemeinen Formulierungen.
Ohne Reranker bekommt das Sprachmodell diese zwölf Abschnitte. Es muss den richtigen selbst herausfinden, während elf andere ablenken. Manchmal gelingt das. Manchmal entsteht eine Antwort, die plausibel klingt und aus dem falschen Absatz stammt.
Mit Reranker steht derselbe Abschnitt auf Platz eins, mit einem Relevanzwert nahe eins. Die allgemeinen Passagen liegen bei nahezu null. Und weil die Trennung so scharf ist, kann das System sie einfach weglassen. Das Sprachmodell sieht dann nur noch das, was wirklich zur Frage gehört.
Weniger, aber relevantere Abschnitte sind nicht nur schneller. Sie sind auch sicherer. Untersuchungen zeigen, dass Sprachmodelle Informationen in der Mitte eines langen Prompts systematisch übersehen. Jeder Abschnitt, der nicht zur Frage gehört, verdrängt einen, der dazugehört.
Was ein Reranker nicht kann
Ein Reranker sortiert nur, was ihm die erste Suche gegeben hat. Steht der richtige Abschnitt nicht unter den vierzig Kandidaten, kann er ihn nicht nach vorne holen. Die erste Suche muss deshalb breit genug sein, Kasimir kombiniert dafür eine Bedeutungssuche mit einer Wortsuche, damit auch deutsche Wortzusammensetzungen und Normnummern zuverlässig gefunden werden.
Und ein Reranker ersetzt kein Sprachmodell. Er entscheidet, was gelesen wird, nicht, was geantwortet wird.
Wie Kasimir den Reranker einsetzt
Seit September 2026 bewertet Kasimir alle Kandidaten der Dokumentensuche mit einem eigenen Reranker nach. Das Modell dahinter ist Qwen3-Reranker, ein offenes Modell, das auf unserer eigenen GPU-Infrastruktur in Deutschland läuft. Kein Textabschnitt verlässt dafür unsere Systeme.
Wir haben vorher zwei Optionen gemessen: den eigenen Reranker und einen kommerziellen Dienst über eine europäische Cloud. Der eigene war bei vierzig Abschnitten schneller, kannte keine Mengenbegrenzung und trennte deutlich schärfer zwischen passend und unpassend. Die Entscheidung fiel leicht.
Wir haben danach nachgemessen, was sich an den Antworten ändert. Grundlage waren sechzig echte Fragen aus dem laufenden Betrieb, jede einmal mit und einmal ohne Nachbewertung, die Ergebnisse blind verglichen.
Das Ergebnis ist zweigeteilt. Die Reihenfolge wird deutlich besser: Wo sich der erste Treffer unterscheidet, ist der nachbewertete in 28 von 34 Fällen der passendere. Die fertigen Antworten dagegen waren in beiden Varianten gleich gut. Das Sprachmodell findet die richtige Stelle offenbar auch dann, wenn elf weitere Abschnitte danebenstehen.
Der Gewinn liegt deshalb woanders, als man zuerst vermutet: Es gehen rund 60 Prozent weniger Text ins Modell, bei gleicher Antwortqualität. Das spart Kosten und Zeit und lässt mehr Platz für Gesprächsverlauf und Anhänge. Wir schreiben das hier offen hin, weil die Gegenprobe sonst niemand macht.
In der Praxis bekommt das Sprachmodell jetzt statt immer zwölf Abschnitten nur noch die, die über einer Relevanzschwelle liegen, meist zwischen vier und acht. Die Nachbewertung kostet rund 150 Millisekunden pro Frage. Fällt der Reranker aus, bleibt die bisherige Reihenfolge, die Suche funktioniert also in jedem Fall.
Fazit
Ein Reranker ist die zweite Meinung in einer Suche. Die erste Suche ist schnell und findet Kandidaten, der Reranker ist gründlich und wählt aus. Was er zuverlässig leistet, ist die bessere Reihenfolge: Die belegende Stelle steht vorn statt irgendwo in der Liste. Ob dadurch auch die fertige Antwort besser wird, hängt vom Sprachmodell ab — und lässt sich nur messen, nicht behaupten. Sicher ist der zweite Gewinn: deutlich weniger Text im Kontext, bei gleicher Qualität. Und das alles lässt sich vollständig auf eigener Infrastruktur betreiben, ohne dass Dokumente das Unternehmen verlassen.
Was sich dadurch für Kasimir-Nutzerinnen und -Nutzer konkret ändert, steht im Changelog.
Ultralytics: Reranker, Glossar-Eintrag. https://www.ultralytics.com/de/glossary/reranker
Zhang et al.: Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models, 2025. https://arxiv.org/abs/2506.05176
Liu et al.: Lost in the Middle: How Language Models Use Long Contexts, 2023. https://arxiv.org/abs/2307.03172
DSGVO-konforme KI aus einem echten deutschen Rechenzentrum
Kasimir läuft auf eigener Infrastruktur in Deutschland — kein Umweg über US-Anbieter, keine CLOUD-Act-Reichweite.