KI im Unternehmen
Open Weights im Oktober 2026: Warum offene Modelle für fast alles reichen
Rund 97 Prozent der Arbeit auf Kasimir erledigen unsere Nutzer mit offenen Modellen. Und jeden Monat kommen stärkere dazu. Was sich seit dem Sommer getan hat, wie wir neue Modelle testen und wo in den Lizenzen Fallen stecken.
Als Betreiber einer KI-Plattform sehen wir jeden Tag, womit unsere Nutzer tatsächlich arbeiten. Und das Bild ist eindeutig: Rund 97 Prozent ihrer Arbeit auf Kasimir erledigen sie mit offenen Modellen. Die großen geschlossenen Spitzenmodelle stehen im selben Auswahlmenü, einen Klick entfernt. Gebraucht werden sie selten.
Das ist keine Vorgabe von uns, sondern eine Entscheidung, die unsere Nutzer selbst treffen: E-Mails, Zusammenfassungen, Recherchen, die Arbeit mit eigenen Dokumenten und Daten — für den Alltag in einem Unternehmen liefern offene Modelle heute Ergebnisse auf Spitzenniveau. Und die Entwicklung hat gerade erst Fahrt aufgenommen: Fast jeden Monat erscheint ein offenes Modell, das mehr kann als das vorherige.
Vor zwei Jahren mussten wir noch erklären, warum ein offenes Modell für die tägliche Arbeit reicht. Heute stellt sich eher die Frage, wofür man überhaupt noch etwas anderes braucht.
In diesem Beitrag zeigen wir, was sich bei offenen Modellen seit dem Sommer getan hat, worauf wir beim Testen achten und welche Stolperfallen in den Lizenzen stecken.
Ein Jahr, in dem offene Modelle aufgeholt haben
2026 ist das Jahr, in dem viele große Modellfamilien ihre offenen Modelle unter echte Open-Source-Lizenzen gestellt haben. Gemma 4 von Google erschien im April erstmals unter Apache 2.0, Mistral veröffentlicht seine gesamte Mistral-3-Familie unter dieser Lizenz, OpenAI seine gpt-oss-Modelle ebenfalls. Seitdem folgt eine Veröffentlichung auf die nächste.
Für unsere Kunden ist das eine gute Nachricht. Die Modelle, mit denen sie heute schon gut zurechtkommen, bekommen laufend stärkere Nachfolger — und weil Kasimir offene Modelle auf eigener Hardware in Deutschland betreibt, können wir neue Modelle aufnehmen, sobald sie bei uns überzeugt haben.
Zwei Klassen, ein Missverständnis
Offene Modelle haben sich in zwei Klassen geteilt, und viele Vergleichsartikel werfen sie durcheinander.
In der ersten Klasse stehen die Spitzenmodelle mit Hunderten Milliarden bis Billionen Parametern. Ihre Gewichte liegen öffentlich zum Download bereit. Betreiben kann sie trotzdem kaum jemand außerhalb eines großen Rechenzentrums. Wie deutlich das ist, zeigt ein Satz aus DeepSeeks Ankündigung von V4.1-Flash im September:
„Planning a large-scale deployment with 2,000 GPUs + a storage cluster? Let's talk.“
In der zweiten Klasse stehen Modelle, die auf eine einzelne professionelle Grafikkarte passen. Dazu gehören kompakte Modelle mit etwa 20 bis 35 Milliarden Parametern, aber auch größere wie gpt-oss-120b: OpenAI liefert es bereits komprimiert aus, und pro Wort rechnet nur ein kleiner Teil seiner 117 Milliarden Parameter mit. Solche Modelle laufen mit vorhersehbaren Kosten und lassen sich in vielen deutschen Rechenzentren betreiben. Genau diese Klasse ist in den letzten zwölf Monaten so gut geworden, dass sie den Arbeitsalltag fast vollständig abdeckt.
Open Source oder Open Weights? Offene Gewichte heißen: Du darfst das fertige Modell herunterladen und betreiben. Trainingsdaten und Trainingscode bekommst du dabei nicht. Warum wir den Unterschied trotzdem für entscheidend halten, beschreiben wir ausführlich in Offene KI-Modelle: Warum das Herz von Kasimir Open Source ist.
Wie wir neue Modelle testen
Bevor ein neues Modell bei unseren Kunden ankommt, durchläuft es bei uns eine Testphase. Eine gute Platzierung auf einer Rangliste reicht dafür nicht. Wir schauen auf das, was im Arbeitsalltag zählt:
Deutsch: Schreibt das Modell sauberes, natürliches Deutsch, auch in Fachsprache?
Werkzeuge: Kann es zuverlässig im Web suchen, Dateien lesen und mit verbundenen Diensten arbeiten, ohne aus der Rolle zu fallen?
Dokumente: Kommt es mit langen Unterlagen, Tabellen und Bildern zurecht?
Lizenz und Betrieb: Ist die Lizenz sauber, und läuft das Modell wirtschaftlich auf Hardware in Deutschland?
Unser selbst betriebenes KI-Modell hat sich seinen Platz verdient. Wir betreiben kein Modell, nur weil es gerade eine Rangliste anführt. Es muss uns zeigen, dass es auf Deutsch sauber arbeitet, Werkzeuge zuverlässig bedient, mit langen Dokumenten zurechtkommt und in unsere Infrastruktur passt.
Was gerade auf der Testbank liegt
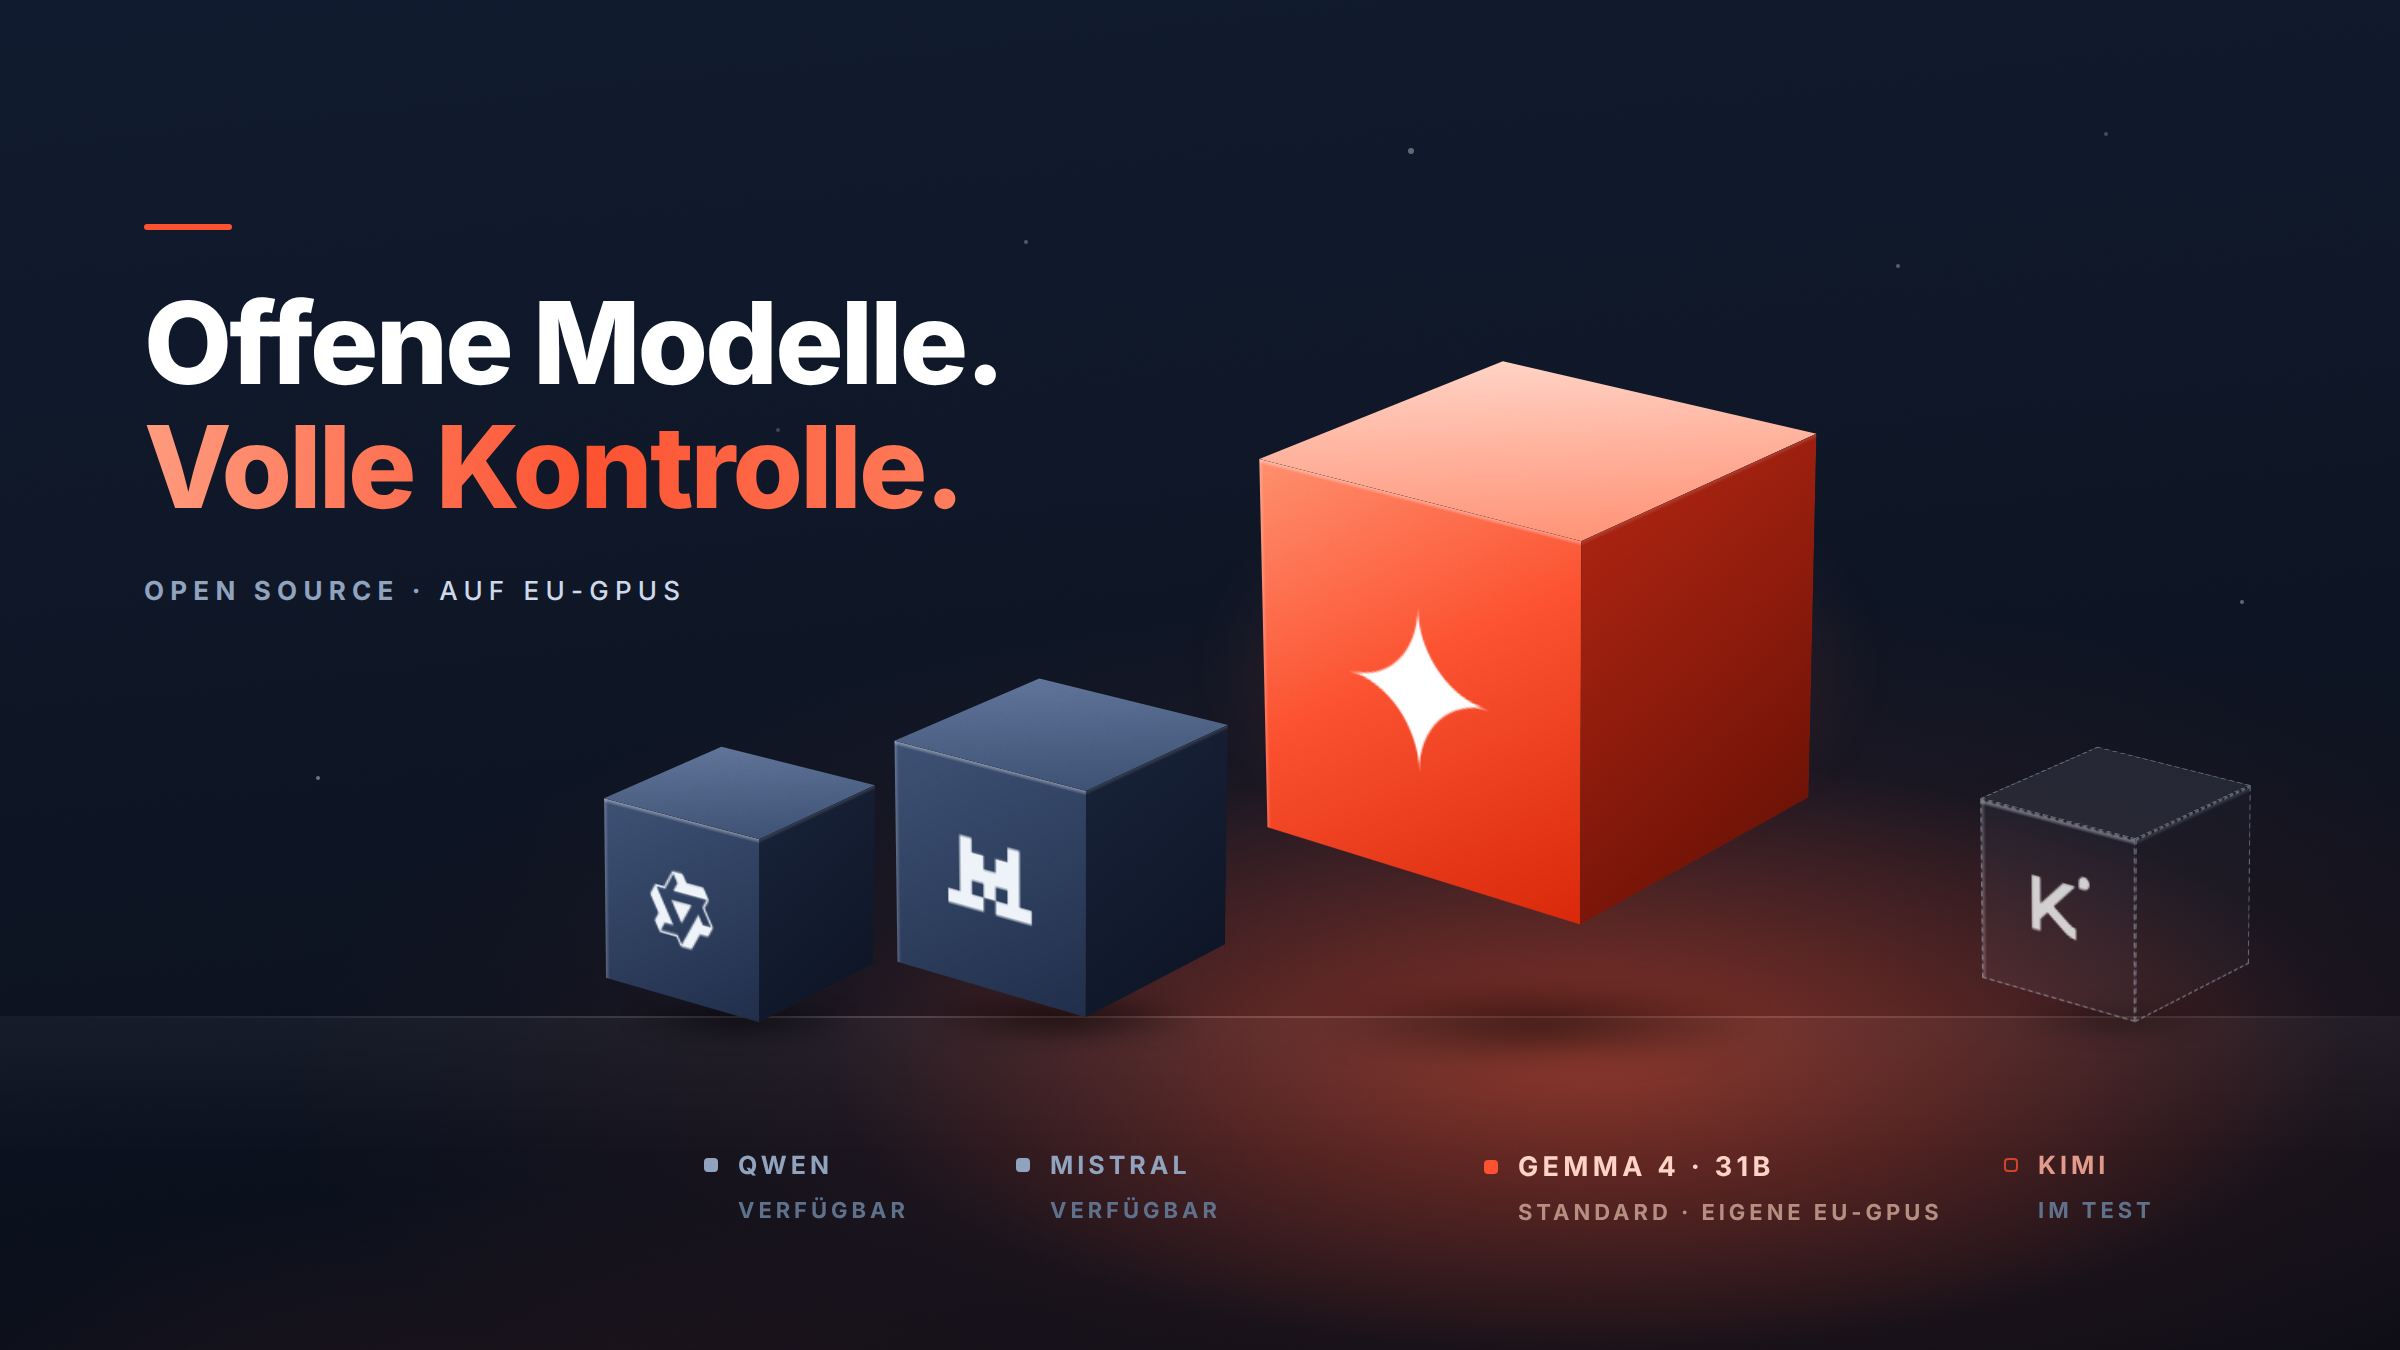
Qwen3.8-27B. Apache 2.0, 27 Milliarden Parameter mit Bildverständnis, sehr langer Kontext. Gleiche Klasse wie die Modelle, mit denen unsere Nutzer heute arbeiten, und damit ein direkter Kandidat für den nächsten Schritt.
gpt-oss-120b und gpt-oss-20b. Apache 2.0. Beim großen Modell rechnet pro Wort nur ein kleiner Teil der Parameter mit, und trotz seiner Größe passt es auf eine einzelne Karte. Das verspricht schnelle Antworten bei großer Wissensbreite.
Mistral Small 4. Apache 2.0, aus der EU. Anders als der Name vermuten lässt, ist es mit 119 Milliarden Parametern kein kleines Modell mehr, rechnet aber pro Wort nur mit einem Bruchteil davon.
DeepSeek-V4.1-Flash. MIT-Lizenz, bis zu einer Million Token Kontext. Kein Kandidat für eine einzelne Karte, aber interessant für Aufgaben mit sehr langen Unterlagen.
Und am Horizont stehen bereits die nächsten: Mistral hat Anfang Oktober Large 4 vorgestellt und die offenen Gewichte für Ende Oktober angekündigt. Alibaba hat mit Qwen4 eine neue Generation angekündigt, die auch wieder ein Modell der 27-Milliarden-Klasse enthalten soll.
Die Lizenz ist der Teil, den niemand liest
Nicht jedes offene Modell ist gleich offen. Alibaba hat im August beide Enden seiner Qwen-3.8-Reihe veröffentlicht, im Abstand von ein bis zwei Tagen und mit völlig verschiedenen Rechtslagen. Das kleine Modell steht unter Apache 2.0. Das große, Qwen3.8-Max, steht unter einer eigenen Lizenz mit einer Umsatzschwelle:
„If the licensee or any of its affiliates conducts a Model as a Service or AI Work Assistant business, and the aggregate revenue of the licensee and its affiliates exceeds US$50,000,000 (or the equivalent amount in any other currencies) during any consecutive twelve (12) months, the licensee shall obtain a separate license from Qwen before Using the Software or its derivative works for any commercial purpose.“
Übersetzt: Wer mit Modell-Hosting oder einem KI-Arbeitsassistenten mehr als 50 Millionen US-Dollar im Jahr umsetzt, braucht einen gesonderten Vertrag. Die rein interne Nutzung ist davon ausgenommen, solange weder das Modell noch seine Ergebnisse Dritten zugänglich gemacht werden. Ab 100 Millionen monatlich aktiven Nutzern oder 20 Millionen US-Dollar Monatsumsatz verlangt dieselbe Lizenz außerdem, den Modellnamen gut sichtbar anzuzeigen.
Metas Llama-4-Modelle stehen unter einer eigenen Community-Lizenz, die die Open Source Initiative ausdrücklich nicht als Open Source anerkennt. Sie enthält eine Schwelle von 700 Millionen monatlich aktiven Nutzern und schließt bei den multimodalen Modellen Nutzer mit Sitz in der EU aus.
Unser Rat: Prüfe die Lizenzdatei im Modell-Repository, nicht die Pressemitteilung. Zwei Modelle derselben Familie, kurz nacheinander veröffentlicht, können völlig unterschiedliche Pflichten auslösen.
Europäische Modelle: die ehrliche Einordnung
Auch aus Europa kommen offene Modelle: EuroLLM mit 22 Milliarden Parametern unter Apache 2.0, die Mistral-Familie aus Frankreich und Apertus aus der Schweiz, das im Juli in Version 1.5 erschienen ist. Teuken-7B aus dem Projekt OpenGPT-X wurde mit allen 24 EU-Amtssprachen trainiert. Hier lohnt der Blick in die Lizenz: Die aktuelle Version steht unter einer nicht kommerziellen Lizenz, nur eine ältere Fassung unter Apache 2.0.
Wichtiger als die Herkunft eines Modells ist aber, wo es läuft. Ein Modell ist eine Datei mit Zahlen. Wo diese Datei ausgeführt wird und wer darauf Zugriff hat, entscheidet über Datenschutz und Datensouveränität, nicht der Ort, an dem sie trainiert wurde. Wir freuen uns über jedes starke europäische Modell und nehmen jedes in unsere Tests auf.
Die Frage, die du einem KI-Anbieter stellen solltest, lautet nicht „Ist das Modell aus Europa?“, sondern: „Auf welcher Hardware, in welchem Rechenzentrum und unter wessen Kontrolle läuft das Modell — und fließen meine Eingaben in ein Training?“
Was das rechtlich bedeutet
Seit dem 2. August 2026 kann das KI-Büro der EU die Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck auch mit Bußgeldern durchsetzen. In Deutschland ist seit Ende Juli das KI-Marktüberwachungs- und Innovationsförderungsgesetz (KI-MIG) in Kraft, die Aufsicht liegt bei der Bundesnetzagentur. Für Modelle unter freier Lizenz sieht die KI-Verordnung Erleichterungen vor: Eine Strategie zum Urheberrecht und eine Zusammenfassung der Trainingsdaten bleiben Pflicht, einige Dokumentationspflichten entfallen. Für Modelle mit systemischem Risiko gilt diese Erleichterung nicht.
Für die meisten Unternehmen entscheidend: Wer ein fertiges Modell einsetzt, ist in aller Regel Betreiber und nicht Anbieter. Damit gelten deutlich schlankere Pflichten als für den, der das Modell veröffentlicht. Eine rechtliche Prüfung im Einzelfall ersetzt das nicht.
Was wir daraus mitnehmen
- Offene Modelle reichen für den Alltag
Rund 97 Prozent der Arbeit auf Kasimir laufen über offene Modelle, obwohl die geschlossenen Spitzenmodelle danebenstehen.
- Es wird nur besser
Jede neue Generation bringt mehr Leistung in kleinere Modelle, und die nächsten sind schon angekündigt.
- Lies die Lizenz
„Open Weights“ reicht von MIT und Apache 2.0 bis zu Lizenzen mit Umsatzschwellen und Ländergrenzen.
Kasimir ist genau darauf gebaut: offene Modelle, betrieben auf Hardware in Deutschland, ohne dass Eingaben in fremdes Training fließen. Welche Modelle dabei vorne stehen, darf sich ändern — genau dafür testen wir.
DSGVO-konforme KI aus einem echten deutschen Rechenzentrum
Kasimir läuft auf eigener Infrastruktur in Deutschland — kein Umweg über US-Anbieter, keine CLOUD-Act-Reichweite.